当行业还在比拼大模型的参数规模、上下文长度与每秒 Token 产出时,一场更底层的推理架构革命正在 2026 年悄然走向量产。过去六年,AI 推理的主流范式始终是「请求式」:用户发起一次请求,服务端加载模型权重、填充上下文、执行推理、返回结果、释放状态。这套模式完美适配一次性问答、单轮生成等离散场景,却正在成为连续型 AI 系统的核心性能瓶颈。
持久化推理引擎(Persistent Inference Engine) 正在打破这一范式。它的核心逻辑是:让模型权重常驻内存/显存,让推理状态跨请求持久保持,让上下文与记忆增量更新而非每次重建。这不是简单的接口优化,而是 AI 基础设施层面的范式重构,正在重新定义智能体、实时交互、端侧 AI 与分布式算力网络的运行方式。
一、请求式推理为什么走到了瓶颈
传统推理链路遵循严格的“生命周期”:接收请求 → 加载模型权重 → 初始化 KV 缓存 → 填充提示词 → 执行前向计算 → 生成输出 → 清空缓存、释放资源。短则数百毫秒,长则数秒,一次请求对应一次完整的推理启停。
在以问答、生成为主的 1.0 时代,这套机制高效且经济。但进入智能体与实时交互时代,它的结构性缺陷全面暴露:
- 冷启动开销刚性存在:百亿级模型冷启动加载动辄数秒,Serverless 场景下甚至可达数十秒。对于需要频繁触发的轻量 Agent 任务,启动开销远大于推理本身。
- 状态无法跨请求延续:每一轮对话都要重传完整历史上下文,长对话与长任务场景下,冗余计算量随长度线性甚至指数级上升。绝大多数算力都浪费在了“重复理解已经理解过的内容”上。
- 智能体认知连续性断裂:Agent 需要持续感知、记忆、规划、迭代决策,但每次推理都要重建全部记忆与状态,不仅延迟高,还极易出现上下文丢失、记忆断层、决策前后不一致。
- 算力资源碎片化:多请求重复加载同一模型,显存被分割为大量独立实例,无法共享权重;请求结束后资源闲置,峰值与谷值利用率差距可达数倍。
这些问题靠单纯的模型压缩、算子优化、KV 缓存量化已经无法根治。底层逻辑不改变,性能提升就会很快触碰到天花板。
二、持久化推理的核心技术架构
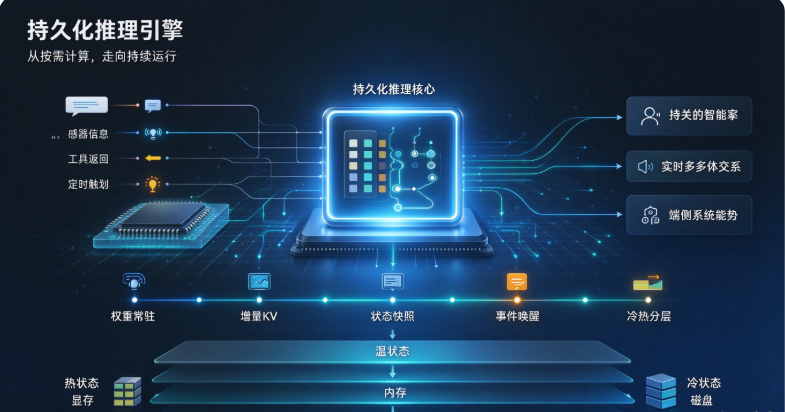
持久化推理的本质,是把“模型”从“每次调用加载的程序”变成“常驻运行的进程”,把“上下文”从“每次传入的输入”变成“可增量更新的状态”。其技术体系围绕四大核心机制构建。
1. 权重常驻与多会话实例共享
模型权重一次性加载进显存/内存,作为全局共享实例服务多路请求,不再按请求加载卸载。与传统批处理(Batch)不同,它不是把多个请求拼成一次前向计算,而是让多会话共享同一份权重,通过独立的上下文槽位实现逻辑隔离。
这带来的收益是颠覆性的:单张 GPU 承载的并发会话数可以提升一个数量级,权重加载开销被摊薄到几乎为零。对于 70B 级模型,在相同显存下,持久化架构的并发处理能力通常是传统请求式架构的 8~12 倍。
2. 增量 KV 缓存与状态快照
传统推理每轮都要重建完整 KV 缓存,持久化引擎则只做增量追加。新的输入只计算新 Token 的 KV 并追加到已有缓存尾部,历史状态完全复用。
更进一步,引擎支持推理状态快照(Inference Snapshot):可以将任意时刻的完整推理状态(KV 缓存、注意力状态、内部隐变量)序列化存储。后续请求无需重跑前置提示词,直接载入快照即可恢复到对应认知节点,继续执行推理。这相当于给 AI 的“思考过程”打上了可恢复的存档点。
3. 内存分层与冷热状态交换
为了支撑上万路并发持久会话,持久化引擎普遍采用三级存储架构:
- 热状态:活跃会话的 KV 与上下文保留在高带宽显存中,毫秒级响应;
- 温状态:休眠会话的状态快照迁移至 CPU 内存,唤醒时百毫秒级回迁;
- 冷状态:长期闲置的状态序列化至磁盘,按需加载。
通过冷热自动调度,用存储容量换并发容量,实现“有限显存支撑近乎无限的持久会话”。2026 年主流方案已经可以在单张 80GB 显卡上稳定承载超过 2 万路休眠会话,同时保持数百路热会话实时响应。
4. 事件驱动的推理唤醒
持久化模型不会持续空转消耗算力,而是采用事件驱动机制:外部消息、传感器数据、定时触发器、工具调用返回等事件,唤醒对应会话执行增量推理,完成后立刻回到低功耗待机状态。
这让 AI 系统可以像操作系统的后台进程一样运行:平时静默驻留,事件触发即唤醒计算,始终保持状态连续性,同时维持极低的 idle 功耗。
三、重构三大核心 AI 场景
持久化推理不是单一技术点的优化,而是会系统性重构所有对连续性、实时性、一致性有要求的 AI 场景。
1. 智能体拥有真正的“连续认知”
这是受益最直接的领域。过去的 Agent 本质是“触发式脚本”:收到指令 → 加载记忆 → 推理决策 → 输出结果 → 遗忘状态。下一次调用还要重新加载全部记忆。
持久化推理下,Agent 成为一个持续运行的认知进程:记忆、规划、工具调用结果、环境感知数据直接增量写入推理状态,无需每次都把历史全部喂回去。响应延迟从秒级压缩到百毫秒级,且认知状态始终一致,不会出现上下文丢失、前后决策矛盾、长任务记忆断层等经典问题。
更重要的是,Agent 可以真正实现“后台自主运行”:不需要人类每步发指令,它持续保持对目标的关注,自主感知环境变化,增量更新决策,自主调度工具执行,状态全程连续不中断。
2. 实时多模态交互的算力革命
直播数字人、实时语音翻译、工业视觉质检、自动驾驶感知等流式场景,过去的做法是逐段截取数据、分段送推理,不仅延迟高,还容易出现段与段之间的上下文割裂。
持久化推理引擎维持连续的感知状态,音频流、视频流逐帧增量输入,模型只对新数据做增量计算,无需每次都对整段内容重新理解。实测数据显示,在连续语音同传场景中,持久化架构的端到端延迟降低 70% 以上,单位时长算力消耗下降 60%,同时语义连贯性显著提升。
3. 端侧 AI 从“APP 功能”变成“系统能力”
在手机、PC、嵌入式设备上,过去每个应用各自集成 AI 模型,重复占用内存,冷启动慢。持久化推理让小模型成为系统级常驻服务:一份模型权重常驻内存,所有应用通过标准接口调用,各自上下文隔离。
2026 年的端侧 AI 方案已经验证:系统级常驻模型相比应用级分散部署,整体内存占用降低 40%50%,首次调用响应速度提升 1020 倍。系统级写作助手、实时屏幕理解、全局翻译、环境感知等能力,都基于同一个常驻模型实例,真正实现 AI 能力的系统级下沉。
四、AI 基础设施的深层重构
持久化推理不止影响模型运行效率,更会重构整个算力基础设施的形态与商业模式。
首先,算力交付模式从“按 Token 计费”转向“按实例时长计费”。过去云厂商卖的是“单次推理服务”,按 Token 消耗量结算;持久化时代,算力变成“常驻模型实例”,用户租用一个 7×24 小时运行的模型进程,按占用的显存配额与时长付费,Token 本身不再是核心计费单位。
其次,分布式推理从“算力调度”进化为“状态调度”。多个持久化推理节点之间可以同步状态快照,实现会话迁移、故障转移、跨地域协同。Agent 的认知状态可以在不同算力节点之间漂移,哪里有空闲算力就在哪里继续运行,状态不中断、会话不重置。
最后,算力的价值重心从“计算”转向“状态管理”。基础模型推理会越来越廉价,而状态持久化、多端同步、快照备份、安全隔离、冷热分层等状态管理能力,会成为新的增值点与利润中心。
五、尚未解决的边界与挑战
持久化推理并非完美方案,它也带来了新的技术挑战。
最核心的是内存墙。常驻模型与海量会话状态对存储容量与带宽提出极高要求,状态压缩算法、内存池调度、分层存储效率都会成为决定上限的关键。
其次是状态一致性与隔离性。多会话共享模型实例,必须从硬件层面严格隔离上下文状态,防止会话串扰;状态快照的版本兼容、一致性校验、增量合并也都是复杂的工程问题。
最后是资源调度的精细度。常驻实例如果长期闲置会造成算力浪费,休眠深度、唤醒阈值、弹性伸缩策略都需要重新设计,在性能与成本之间找到新的平衡。
持久化推理的本质,是让 AI 从“按需调用的计算工具”,变成“持续运行的数字系统”。
过去的 AI 更像计算器:你输入,它计算,它停止。而持久化推理给了 AI 一个“持续存在”的载体——它可以一直保持认知状态,持续感知环境,增量更新决策,像一个真正的数字实体一样运行。
这不是一次简单的引擎升级,而是整个 AI 运行范式的转折。当推理不再是一次次孤立的计算,而是连续的、持久的、有状态的进程,智能体的自主运行、实时多模态交互、分布式智能经济,才真正拥有了坚实的底层算力支撑。
而这场由推理架构引发的变革,才刚刚开始。